
| 日 | 月 | 火 | 水 | 木 | 金 | 土 |
27 | 28 | 29 | 30 | 1 | 2 | 3 |
4 | 5 | 6 | 7 | 8 | 9 | 10 |
11 | 12 | 13 | 14 | 15 | 16 | 17 |
18 | 19 | 20 | 21 | 22 | 23 | 24 |
25 | 26 | 27 | 28 | 29 | 30 | 31 |
お知らせ
「学習者の振る舞いを模倣する模倣学習エージェントを用いた教育システムの開発」
課題番号:19K12260
研究代表者:植野 雅之(大阪電気通信大学)
研究分担者:高見 友幸(大阪電気通信大学)
和田 慎二郎(プール学院大学短期大学部)
1 研究目的、研究方法など
(概要)
本研究は,論理的ボードゲームの戦術・戦略的スキルの学習において,学習者の振る舞いを機械学習により,そのスキルや癖を含めて学習させ,ほぼ同様の振る舞いができるような「模倣学習エージェント」を開発し,自分を振り返るための教育的な「鏡」として利用できるかを検証する.さらに複数の学習者に模倣学習エージェントを適用し,ネットワーク化することで競争的かつ協調的な教育環境を構築する.ここでは模倣学習エージェント同士の仮想対戦を用いて,戦術・戦略的スキルの多様な試行錯誤が可能となる.これらを実装し,教育的検証をおこなうことで模倣学習エージェントに基づく教育システムの新たな可能性を探る.
(本文)
(1)本研究の学術的背景,研究課題の核心をなす学術的問い
知識情報処理などの人工知能技術を教育システムに生かそうとする試みは,知的教育システム(Intelligent Tutoring Systems: ITS)研究として,様々なシステムが提案・開発されてきた.しかし,現時点の技術水準では,人間の教師をシミュレートする人工知能を作ることは難しいと考えられるため,機械知と人間知の非対称性を越えて知的な刺激を与えることができる 知的教育システムとして,教育エージェント(Pedagogical Agent)の研究が進められている.これは,全てを理解しつつ学習者を監督できるような教師としての大がかりな人工知能システムを構築しようとするのではなく,一定の部分的役割を担うことのできる複数のエージェントにより,教育の支援をおこなうという発想である.教育エージェントとしては,単にシミュレータなどの事象を説明するものや,学習における共同学習者に近い存在を作り出そうとする学習コンパニオン(Learning Companion)などの発想もある.また,擬似的な共同学習者をシミュレートし,学習者に教えさせることで学習者に学習内容のより深い理解を促 すものなどがある.
本研究課題の学術的「問い」は,人間が機械知と協調して発展する共生関係を実現することができるか?学習者を模倣する模倣学習エージェント群により,その関係に資する有効な 教育エージェントとは何かを模索することである.
(2)本研究の目的および学術的独自性と創造性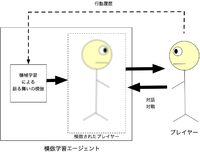
本研究において提案するのは,機械学習を用いて,人間の学習者の振る舞いを模倣する能力を持つ教育エージェント「模倣学習エージェント」である(図1).このエージェントに学習者が持 つ様々なスキルだけでなく,学習者が持っている思い込みなど含めて反映させることができれば,学習者にとって自分を振り返る教育的な意味での一種の「鏡」として機能させることができ,自分が持っている戦略の問題点や見落としていた視点,思い込みなどに気付くことができるようになると考えられる.特に相手が必要な状況における学習,例えば,討論,外国語会話,スポーツなどの対戦,ボードゲームの対局などの学習においては,このような教育エージェントを用意することによって学習に必要な体験の絶対量を大幅に増大することができるようになる.また,これらの学習においては,学習者とエージェント との能力差が小さいほどその欠点や問題に気付きやすくなると考えられるので,高い教育効果が期待できる.
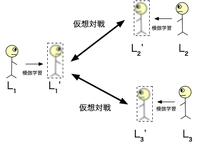
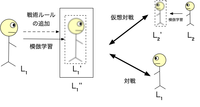
単独の学習者に適用してもこれらの教育的効果が想定できるが,さらに多人数の学習者に適用し,ネットワーク化することにより,人間の学習者を介しない仮想的な対戦・対局がおこなえるようになり,競争的かつ協調的な学習環境の構築が期待できる.この仮想的な対戦・対局を観察することは,自他のスキルを客観視することにつながるなどの効用がある.また,能力の均衡している学習者を選び出したり,新たな戦術ルールを模倣学習エージェントに追加して強化できるようにすることで,戦術・戦略に関する試行錯誤的な学習が可能になる(図2,図3).
すなわち,このような「模倣学習エージェント」を用いることで,それが扱うコミュニケーションにおいて,学習者が持つ暗黙的な戦術・戦略スキル,思い込みを意識させ,明示的な知識に近づける効果があると考えられる.また,複数の学習者による模倣学習エージェント群によるネットワークを構築することで,仮想的な対戦が可能となり,それを用いた様々な試行錯誤による学習が可能となる.
本研究が対象とする学習領域としては,近年,一種の知育として取り上げられることもある将棋・リバーシなどの論理的ボードゲームの戦術・戦略的スキルの学習を扱うこととしたい(「スポーツ」「討論」「外国語会話」等の領域への適用には現時点では技術的課題が多い).ここで言う「論理的ボードゲーム」とは,学術的には「二人零和有限確定完全情報ゲーム」と呼ばれるボードゲームであり,両者の駒の位置などの勝敗に関わる情報が相互にオープンで,有限の時間で勝敗が決着するタイプのゲームである.このような論理的ボードゲームでは,問題解決空間やアクションが明確であるため,振り返りなどもおこないやすい反面,「◯◯戦法」などの形で公式化されている戦術的スキルはわずかで,多くのスキルが暗黙的で伝達が困難という非常に興味深い領域であり,この教育を考えることは教育システム学にとっての挑戦である.ここで得られた知見は他学習領域への応用にも貢献できるのではないかと考えている.
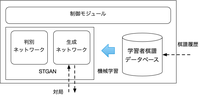
チェスや将棋における模倣学習については,第2章文献(8)などにあるようにプロ棋士の振 る舞いを再現するレベルの模倣学習はある程度,実現されつつある.技術的には大量のデー タを必要とする深層学習において,敵対的生成ネットワーク(Generative Adversarial Network:GAN)と呼ばれる技術を用いて,サンプルに類似する偽のデータを生成する生成ネットワークとその真偽を判定する判別ネットワークを競合させて学習をおこなうことで少数のサンプルからの教師なし学習を可能 にしている.一般的なGANは画像生成の目的に用いられることが多いが,第2章文献(8)では,STGAN(Style Transfer GAN)と呼ばれるGANの拡張により,生成ネットワークが論理的ボードゲームにおける盤面評価のための評価関数となる ように棋譜からの機械学習がおこなわれ るようにすることで実現されている.
図4は文献(8)を参考にした模倣学習エージェントの構造であるが,我々が目的とする模倣学習エージェントでは,この技術を初心者レベルの安定しない限られた履歴から学習者の手を模倣する必要があるため,先述の方法がどこまで適応可能かどうかを検証しながら開発を進める.緊張状態などの心理的要素などの影響等を考慮するなどの一定の工夫が必要になる可能性がある.
(3)本研究で何をどのように,どこまで明らかにしようとするか
本研究では将棋等の論理的ボードゲームにおいて,学習者の履歴から学習者が持つスキルや癖などを学習させる「模倣学習エージェント」を開発し,これを多人数に適用することで作り出すことのできる学習環境の構築とその効果を分析する.
大まかな研究計画としては,5段階で考えている.第1段階として,人間の学習者の論理的ボードゲーム上での振る舞いを模倣することができる模倣学習エージェントを構築する.第2段階として,構築した模倣学習エージェントにより,どの程度,学習者を模倣できるかを検証する.第3段階として,構築した模倣学習エージェントを単独で用いることにより,想定する教育効果が得られるかを確認する.第4段階として,模倣学習エージェントに記号処理的な手法により,戦術ルールを表現して付け加えることで強化する機能を開発し,ルールについての試行錯誤がおこなえるようにする.第5段階として,実際に複数の学習者に適用し,学習環境全体としての教育効果を調べる.
但し,将棋などの比較的規模の大きな論理的ボードゲームについての模倣学習エージェントの開発はスケールがかなり大きなものとなり,開発における試行錯誤がおこないにくくな る可能性がある.模倣学習に関するノウハウを得る必要もあるので,初期段階ではテストとして,比較的シンプルなリバーシなどを対象にした模倣学習エージェントを構築する.ここで模倣学習のための手法を比較し,人間の学習者に追従しやすい手法の見極めをおこなう. 初期段階以降は将棋等の論理的ボードゲームについて,先述の4段階の研究を進めて,模倣学習エージェントによる学習環境の教育効果を検証する.発展的には模倣学習エージェントのニューラルネットワークに組み込まれている戦略・戦術的ルールを分析して可視化するなども研究の進展によっては考えられる.
研究グループとしての役割分担としては,研究代表者・植野は全体を統括するとともにシ ステム開発,教育的評価をおこなう.研究分担者・高見は論理的ボードゲーム部分のシステ ム開発や評価をおこなう.研究分担者・和田は実験,データ分析をおこなう.
カレンダー
アクセスカウンター
2
6
6
8
5
7
8